扫描化学科目的PDF文件
借助 PDF 中的设备端 AI 辅助功能查找化学名称和印刷结构图,独立验证这些信息,并查看结果旁边的来源页面。
开始扫描文档
在“库”中选择“扫描 PDF”,或在文档中选择“添加”>“扫描 PDF”以进行化学分析。从“文件”或其他提供商中选择一个 PDF。扫描结果将显示在当前屏幕上方;点击“返回”可回到该界面。若取消文件选择,该屏幕将保持不变。
所选的 PDF 仍为只读状态。扫描操作不会更改源文档。
对于超过10页的PDF文件,请在扫描前选择起始页和结束页。默认范围为第1至10页;选择“所有页面”将扫描整个文档。缩略图可帮助您选择页面范围。扫描结果将保留原始的PDF页码。
- 选择一个结果,将其在 PDF 页面上显示并突出显示。文本使用其源范围;图形则使用其实例蒙版和边界框。
- 拖动位于“PDF”和“结果”之间的控制柄,为任一侧腾出更多空间。VoiceOver 用户可以通过向上或向下滑动来调整分隔线。
- 点击结果行进行多选,或使用“全选”来选中所有可见的结果。
- 使用 PDF 缩放控件和搜索框,聚焦您感兴趣的关键词。点击高亮显示的 PDF 区域,即可显示其结果行;若启用了筛选条件,该行可能会被隐藏。
- 默认情况下,“仅显示经过验证的IUPAC名称的行”功能处于启用状态。关闭此功能可查看无法翻译的文本候选项以及未匹配到对应名称的已识别图示。
- “导入到受管存储库”功能仅将选定且已确认的、标识符为 Fixed-H InChIKey 的结构统一导入,跳过并报告选定但未包含该标识符的实例,跳过已存在该标识符的结构,并将扫描到的 PDF 文件名作为每次添加操作的源文件名进行记录。
- 导入扫描结果后,“查看库”会带您进入已保存的结构。如果看不到新项目,请清除搜索或筛选条件。点击“返回”则会回到您开始扫描时的屏幕。
- 结果表按文档顺序列出了出现项。名称和图纸若在附近且完全匹配,则共用一行;而重复出现的独立项则保持分开显示。
扫描过程中会发生什么
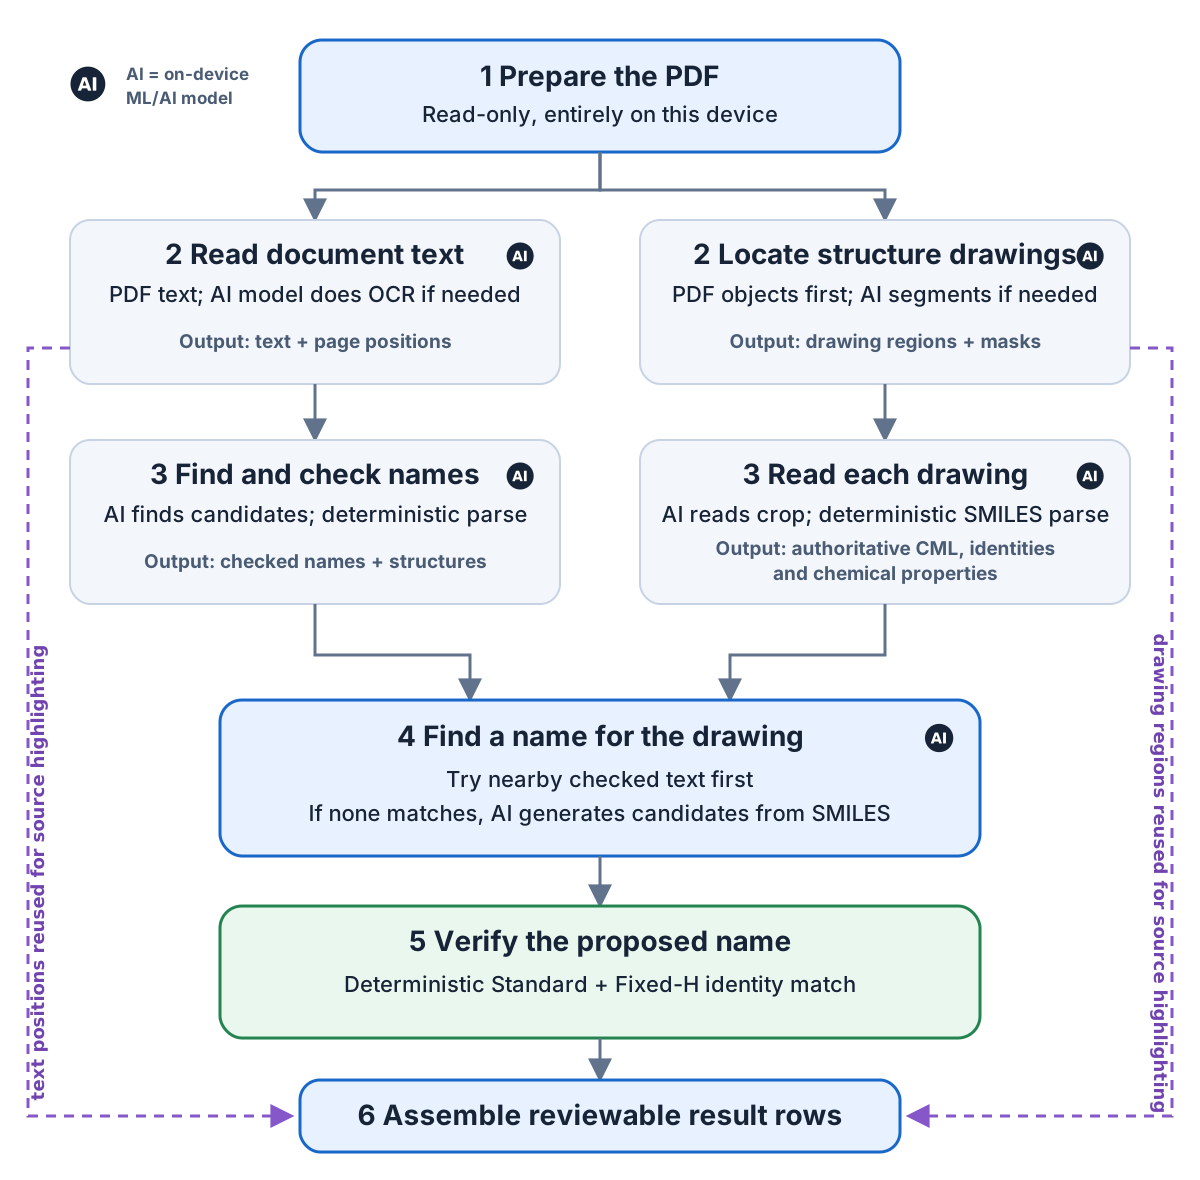
该扫描过程包含一系列在设备上执行的步骤。中间结果会被重复利用,从而确保名称、图纸、验证和源代码高亮标注之间保持关联。
AI 辅助处理:设备端的机器学习模型负责执行 OCR 备用方案、化学名称识别、图画分割与识别,以及备用名称生成。读取嵌入的PDF对象、解析化学描述、计算性质、比对身份、整合结果以及突出显示来源,均为确定性步骤。
- 准备 PDF:读取嵌入文本及其所在页面位置;仅对没有可用文本的页面使用设备端 AI 模型进行 OCR 识别。
- 查找名称:一个设备端AI模型检测可能的化学名称;AtomLens会谨慎地修复PDF的文本和换行,随后一个确定性名称解析器会检查每个候选项。
- 定位图纸:首先检查嵌入的图像和矢量对象;仅在必要时,才在设备上本地或跨整页使用AI分割模型。
- 读取图纸:设备端的人工智能模型将每张图纸转换为 SMILES 格式,随后 AtomLens 会独立且确定性地将其解析为权威结构、标准和固定标识符,以及可用属性。
- 为名称配对:首先尝试附近检测到的名称,仅在必要时才使用独立的离线AI模型,根据识别出的“SMILES”生成候选项。在“AtomLens”接受该名称之前,确定性名称解析必须同时还原两个绘图标识。
- 汇总结果:将相匹配的附近名称和图画合并为一行,保留所有源位置,并将其用于高亮显示、预览、筛选和导入。
阅读验证和结构预览
一个嵌入式人工智能语言模型会找出候选名称,而确定性名称解析功能则会独立验证这些名称。AtomLens首先从PDF自身的图像和矢量对象中定位出已打印的图纸。一个人工智能分割模型会检查合适的对象,或作为整页备用方案运行;而一个人工智能绘图识别模型则将填充后的裁剪区域转换为SMILES,随后由AtomLens独立进行解析。
- Green 的翻译结果已通过确定性名称解析验证,并包含结构缩略图。
- “绿色相邻名称”结果将人工智能识别出的图画与附近文字名称相结合,且该文字名称的“标准”和“固定H”字形与之匹配。
- “Green Generated”生成的名称结果仅在附近没有匹配名称时才会使用离线 AI 模型;确定性名称解析必须在显示名称之前重现两个绘图标识。
- “绿色已识别”的图纸结果是指那些经AI识别后被解析为结构的SMILES图纸,但其中没有名称通过身份验证的图纸。
- 橙色 未翻译的结果可能是名称或无法转换的检测到的图画。AI识别结果并非权威结果,因此在依赖这些结果之前,请先核对标注为PDF的源内容。
准确性、隐私和离线使用
扫描页面、非标准字体、图表、损坏的 PDF 字符映射表、多栏排版以及相邻的标签,仍可能导致候选项缺失、拆分或合并。
印刷图示识别适用于印刷结构,不适用于手绘输入。内容密集的页面、标签、反应式、栅格化以及扫描质量不佳等情况仍可能导致识别结果遗漏或错误。
PDF、文本提取、AI 辅助名称识别、AI 分割、AI 绘图识别、AI 辅助名称生成、确定性结构验证以及缩略图处理均在此 iPad 上进行。所有机器学习/AI 模型和分词器均内置于 AtomLens 中;运行时不会下载或上传任何模型或文档内容。