रसायनशास्त्र के लिए पीडीएफ स्कैन करें
PDF में ऑन-डिवाइस AI सहायता के साथ रासायनिक नाम और मुद्रित संरचना आरेख खोजें, उन्हें स्वतंत्र रूप से सत्यापित करें, और परिणामों के बगल में स्रोत पृष्ठ का निरीक्षण करें।
दस्तावेज़ स्कैन शुरू करें
लाइब्रेरी में Scan PDF चुनें, या दस्तावेज़ में रसायन विज्ञान के लिए Add > Scan PDF चुनें। Files या किसी अन्य प्रदाता से एक PDF चुनें। स्कैन आपकी वर्तमान स्क्रीन के ऊपर खुलता है; Back आपको वहीं वापस ले जाता है। फ़ाइल पिकर रद्द करने पर वह स्क्रीन अपरिवर्तित रहती है।
चयनित PDF केवल-पठन बना रहता है। स्कैनिंग स्रोत दस्तावेज़ को नहीं बदलती।
10 पृष्ठों से अधिक लंबी PDF के लिए स्कैन करने से पहले पहला और अंतिम पृष्ठ चुनें। डिफ़ॉल्ट रूप से पृष्ठ 1–10 चुने जाते हैं; 'सभी पृष्ठ' पूरे दस्तावेज़ को चुनता है। थंबनेल एक सीमा चुनने में मदद करते हैं। परिणाम मूल PDF पृष्ठ संख्याएँ बनाए रखते हैं।
- PDF पृष्ठ पर किसी परिणाम को प्रकट करने और उसे हाइलाइट करने के लिए उसे चुनें। टेक्स्ट अपने स्रोत रेंज का उपयोग करता है; एक ड्राइंग अपने इंस्टेंस मास्क और बाउंडिंग बॉक्स का उपयोग करती है।
- PDF और परिणामों के बीच हैंडल को खींचकर दोनों ओर अधिक जगह दें। VoiceOver उपयोगकर्ता ऊपर या नीचे स्वाइप करके विभाजक को समायोजित कर सकते हैं।
- मल्टी-सेलेक्शन बनाने के लिए परिणाम पंक्तियों पर टैप करें, या प्रत्येक दृश्यमान परिणाम को चुनने के लिए 'सब चुनें' का उपयोग करें।
- PDF ज़ूम नियंत्रणों और खोज क्षेत्र का उपयोग रुचि के शब्दों पर ध्यान केंद्रित करने के लिए करें। हाइलाइट किए गए PDF क्षेत्र पर टैप करें ताकि उसका परिणाम पंक्ति प्रकट हो; एक सक्रिय फ़िल्टर उस पंक्ति को छिपा सकता है।
- केवल मान्य IUPAC नामों वाली पंक्तियाँ दिखाना डिफ़ॉल्ट रूप से सक्षम है। पहचान-मिलान नाम के बिना अनुवादित न हो सकने वाले पाठ उम्मीदवारों और मान्यता प्राप्त चित्रों की समीक्षा करने के लिए इसे बंद करें।
- मैनेज्ड रिपॉजिटरी में आयात केवल Fixed-H InChIKey द्वारा चयनित पुष्टि की गई संरचनाओं को एकीकृत करता है, उस पहचान के बिना चयनित घटनाओं को छोड़ देता है और रिपोर्ट करता है, उस पहचान के साथ पहले से मौजूद संरचनाओं को छोड़ देता है, और प्रत्येक जोड़ के लिए स्कैन किए गए PDF फ़ाइलनाम को स्रोत फ़ाइलनाम के रूप में दर्ज करता है।
- स्कैन परिणाम आयात करने के बाद, व्यू लाइब्रेरी आपको सहेजी गई संरचनाओं पर ले जाती है। यदि नई वस्तुएँ दिखाई नहीं दे रही हैं, तो खोज या फ़िल्टर साफ़ करें। बैक बटन आपको उस स्क्रीन पर वापस ले जाता है जहाँ से आपने स्कैनिंग शुरू की थी।
- परिणाम तालिका दस्तावेज़ क्रम में घटनाओं को सूचीबद्ध करती है। एक पास का पहचान-मिलान नाम और आरेख एक ही पंक्ति में साझा होते हैं; दोहराई गई स्वतंत्र घटनाएँ अलग रहती हैं।
स्कैन के दौरान क्या होता है
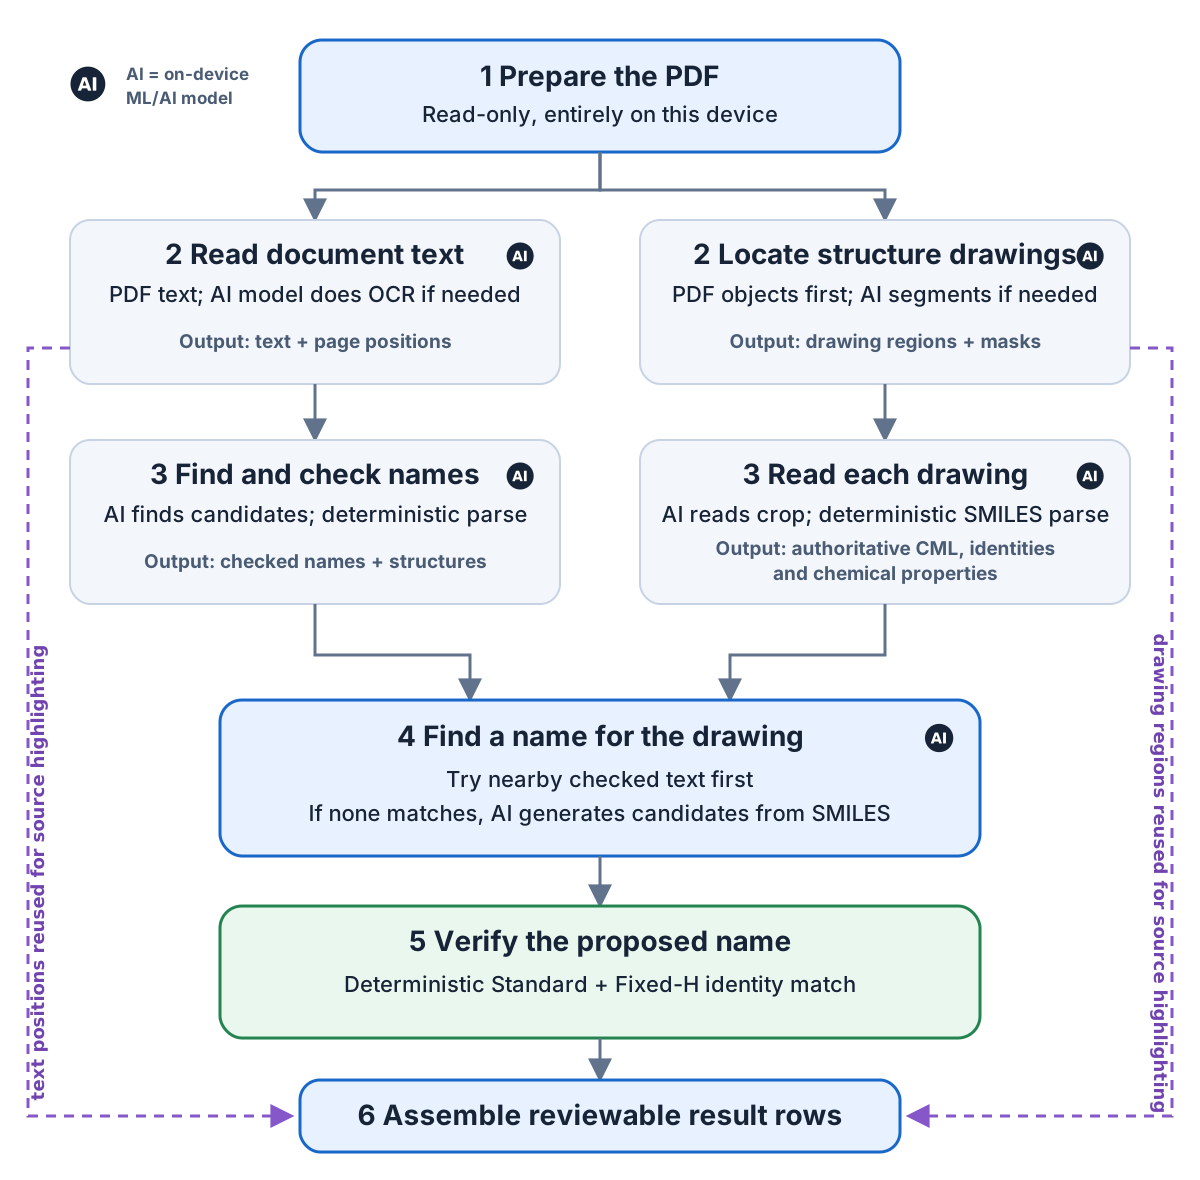
यह स्कैन डिवाइस पर किए जाने वाले कई चरणों का उपयोग करता है। मध्यवर्ती परिणामों को पुन: उपयोग किया जाता है ताकि नाम, चित्र, सत्यापन और स्रोत हाइलाइटिंग आपस में जुड़े रहें।
एआई-सहायक प्रसंस्करण: ऑन-डिवाइस मशीन-लर्निंग मॉडल OCR फॉलबैक, रासायनिक नाम पहचान, आरेख विभाजन और पहचान, तथा फॉलबैक नाम उत्पन्न करने का कार्य करते हैं। एम्बेडेड PDF ऑब्जेक्ट्स को पढ़ना, रासायनिक विवरणों का पार्स करना, गुणों की गणना करना, पहचानों की तुलना करना, परिणामों को संयोजित करना, और स्रोत को हाइलाइट करना निर्धारक चरण हैं।
- PDF तैयार करें: एम्बेडेड टेक्स्ट और उसके पृष्ठ स्थानों को पढ़ें; केवल उन पृष्ठों पर OCR के लिए डिवाइस पर मौजूद AI मॉडल का उपयोग करें जिनमें उपयोग योग्य टेक्स्ट नहीं है।
- नाम खोजें: एक ऑन-डिवाइस एआई मॉडल संभावित रासायनिक नामों का पता लगाता है; AtomLens सावधानीपूर्वक PDF टेक्स्ट और लाइन रैप्स की मरम्मत करता है, फिर एक निर्धारणात्मक नाम पार्सर प्रत्येक उम्मीदवार की जांच करता है।
- ड्राइंग्स का पता लगाएँ: पहले एम्बेडेड इमेज और वेक्टर ऑब्जेक्ट्स का निरीक्षण करें; केवल आवश्यकता पड़ने पर डिवाइस पर मौजूद AI सेगमेंटेशन मॉडल का स्थानीय रूप से या पूरे पेज पर उपयोग करें।
- ड्राइंग्स पढ़ें: एक ऑन-डिवाइस AI मॉडल प्रत्येक क्रॉप को SMILES में परिवर्तित करता है, जिसे AtomLens स्वतंत्र रूप से और निर्धारणात्मक रूप से प्राधिकृत संरचना, मानक और फिक्स्ड-एच पहचानों, और उपलब्ध गुणों में पार्स करता है।
- नाम संलग्न करें: पहले पास में पाए गए नामों को आज़माएँ, फिर केवल आवश्यकता होने पर पहचाने गए SMILES से उम्मीदवार उत्पन्न करने के लिए एक अलग ऑफ़लाइन AI मॉडल का उपयोग करें। निर्धारित नाम पार्सिंग को AtomLens द्वारा नाम स्वीकार करने से पहले दोनों ड्राइंग पहचानों को पुन: उत्पन्न करना चाहिए।
- परिणाम संकलित करें: एक मेल खाने वाले निकटवर्ती नाम और चित्र को एक ही पंक्ति में संयोजित करें, सभी स्रोत स्थितियों को संरक्षित रखें, और उन्हें हाइलाइटिंग, पूर्वावलोकन, फ़िल्टरिंग और आयात के लिए उपयोग करें।
मान्यकरण और संरचना पूर्वावलोकन पढ़ें
एक एम्बेडेड AI भाषा मॉडल उम्मीदवार नामों को खोजता है, और निर्धारणात्मक नाम पार्सिंग उन्हें स्वतंत्र रूप से जांचती है। AtomLens पहले PDF की अपनी छवि और वेक्टर ऑब्जेक्ट्स से मुद्रित चित्रों का पता लगाता है। एक AI सेगमेंटेशन मॉडल उपयुक्त ऑब्जेक्ट्स का विश्लेषण करता है या पूरे पृष्ठ के फॉलबैक के रूप में चलता है, और एक AI ड्राइंग-पहचान मॉडल पैडेड क्रॉप्स को SMILES में परिवर्तित करता है, जिसे AtomLens स्वतंत्र रूप से पार्स करता है।
- ग्रीन ट्रांसलेटेड परिणाम निर्धारणात्मक नाम पार्सिंग द्वारा स्वीकार किए गए थे और इनमें एक संरचना थंबनेल शामिल है।
- ग्रीन एडजेसेंट नाम परिणाम एक एआई-पहचाने गए चित्र को पास के एक पाठ नाम के साथ मिलाते हैं, जिनकी स्टैंडर्ड और फिक्स्ड-एच पहचान मेल खाती हैं।
- Green Generated नाम परिणाम केवल तब ऑफ़लाइन AI मॉडल का उपयोग करते हैं जब कोई निकटवर्ती नाम मेल नहीं मिलता; निर्धारक नाम पार्सिंग को नाम दिखाने से पहले दोनों ड्राइंग पहचानों को पुन: उत्पन्न करना चाहिए।
- ग्रीन रिकॉग्नाइज्ड ड्रॉइंग परिणाम वे मुद्रित चित्र हैं जिनके AI-पहचाने SMILES को एक संरचना के रूप में पार्स किया गया था, लेकिन जिनके लिए कोई नाम पहचान जांच पास नहीं कर पाया।
- नारंगी: अनुवादित नहीं किए गए परिणाम संभावित नाम या ऐसे पता लगाए गए चित्र हो सकते हैं जिन्हें परिवर्तित नहीं किया जा सका। एआई मान्यता पूर्णतः सटीक नहीं होती, इसलिए उन पर भरोसा करने से पहले हाइलाइट किए गए PDF स्रोत की समीक्षा करें।
सटीकता, गोपनीयता, और ऑफ़लाइन उपयोग
स्कैन किए गए पृष्ठ, असामान्य फ़ॉन्ट, आरेख, क्षतिग्रस्त PDF वर्ण मानचित्र, बहु-स्तंभ लेआउट, और निकटवर्ती लेबल अभी भी अनुपस्थित, विभाजित, या संयुक्त उम्मीदवार उत्पन्न कर सकते हैं।
मुद्रित-ड्राइंग मान्यता मुद्रित संरचनाओं के लिए है, हाथ से बनाए गए इनपुट के लिए नहीं। घने पृष्ठ, लेबल, प्रतिक्रिया योजनाएँ, रस्टरकरण और खराब स्कैन अभी भी ड्राइंग के परिणामों में चूक या गलत परिणाम का कारण बन सकते हैं।
PDF से निकाला गया टेक्स्ट, AI-सहायक नाम पहचान, AI सेगमेंटेशन, AI ड्राइंग पहचान, AI-सहायक नाम उत्पन्नकरण, निर्धारक संरचना सत्यापन और थंबनेल इस iPad पर संसाधित किए जाते हैं। सभी ML/AI मॉडल और टोकनाइज़र AtomLens के भीतर ही शामिल होते हैं; रनटाइम के दौरान कोई भी मॉडल या दस्तावेज़ सामग्री डाउनलोड या अपलोड नहीं की जाती।