रसायन विज्ञान के लिए दस्तावेज़ स्कैन करें
PDF में रासायनिक नाम और मुद्रित संरचना आरेख खोजें, स्रोत पृष्ठ के पास प्रत्येक प्रकट होने की समीक्षा करें, और पुष्टि की गई संरचनाओं को आयात करें।
स्कैन शुरू करें
- चुनें
File > Scan Document for Chemistry…. - मानक macOS फ़ाइल पिकर के साथ एक PDF चुनें।
- 10 पृष्ठों से अधिक लंबी PDF के लिए स्कैन करने से पहले पहला और अंतिम पृष्ठ चुनें। डिफ़ॉल्ट रूप से पृष्ठ 1–10 चुने जाते हैं; 'सभी पृष्ठ' पूरे दस्तावेज़ को चुनता है। थंबनेल सीमा चुनने में मदद करते हैं। परिणाम मूल PDF पृष्ठ संख्याएँ बनाए रखते हैं।
- AtomLens एक नेटिव PDF पूर्वावलोकन खोलता है, टेक्स्ट निकालता है, और चयनित पृष्ठों में रासायनिक नामों और मुद्रित संरचना आरेखों के लिए स्कैन करता है।
- दस्तावेज़ के बगल में घटना तालिका की समीक्षा करें। जब PDF या तालिका को अधिक स्थान की आवश्यकता हो, तो विभाजक को खींचें।
PDF रीड-ओनली ही रहता है। स्कैनिंग चयनित दस्तावेज़ को परिवर्तित नहीं करती। iPad पर, लाइब्रेरी में Scan PDF चुनें या Add > Scan PDF for Chemistry in a document चुनें, फिर Files में PDF चुनें। लेबल किया गया बैक बटन प्रारंभिक स्क्रीन पर वापस ले जाता है। इम्पोर्ट करने के बाद, View Library आपके सहेजे गए संरचनाओं को खोलता है। पृष्ठ चयन, प्रसंस्करण, फ़िल्टरिंग और रिपॉजिटरी आयात एक ही वर्कफ़्लो का उपयोग करते हैं; कई परिणामों का चयन करने के लिए पंक्तियों पर टैप करें।
स्कैन के दौरान क्या होता है
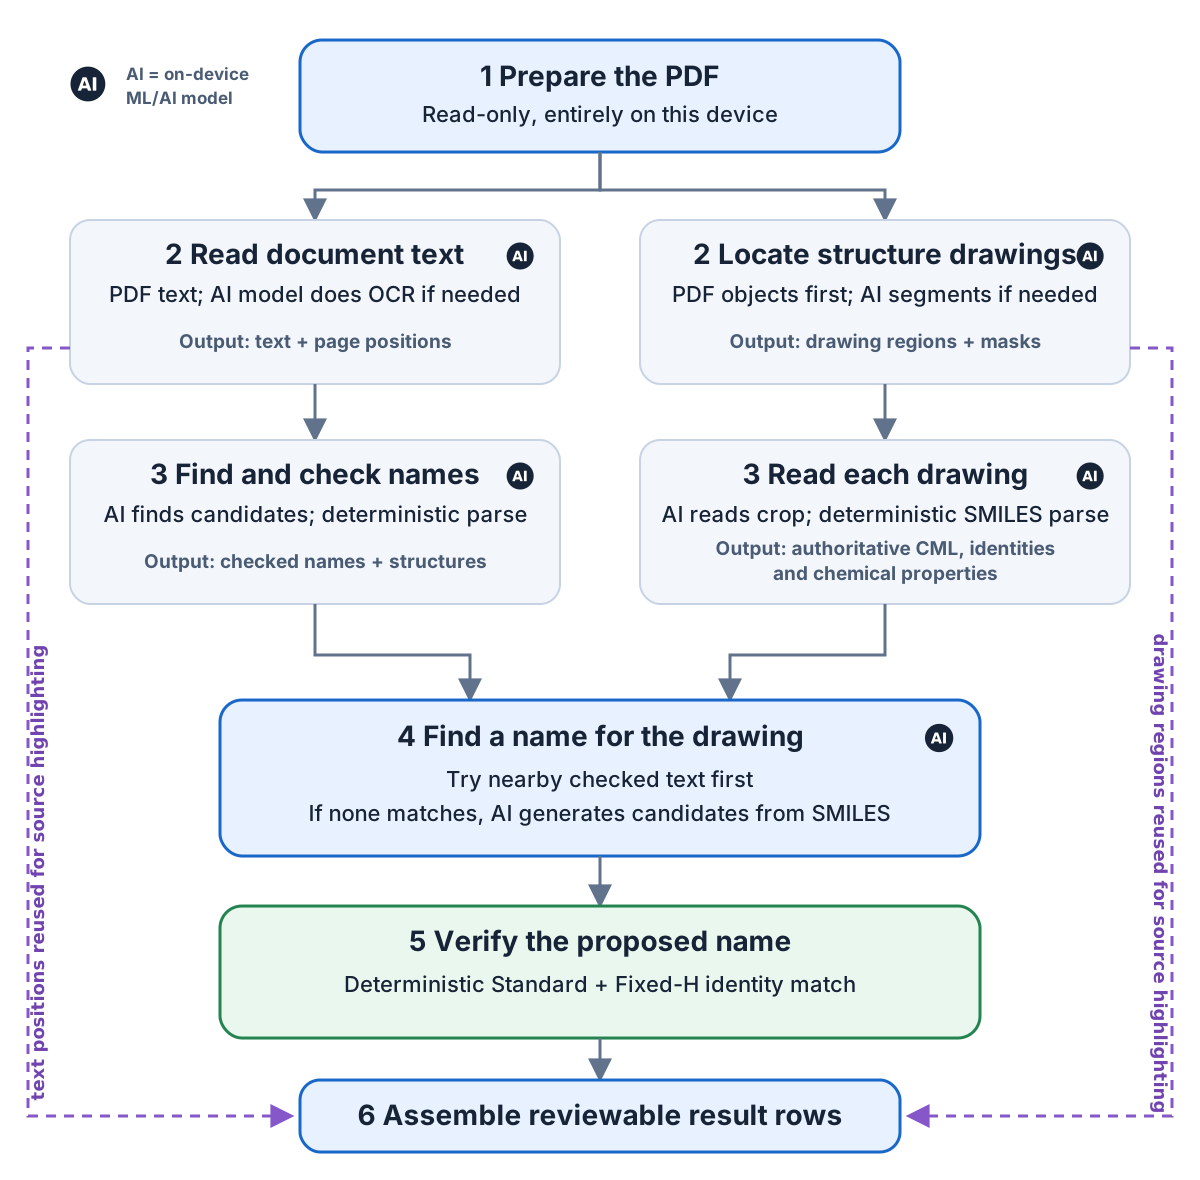
AtomLens दस्तावेज़ को डिवाइस पर ही एक श्रृंखलाबद्ध प्रक्रियाओं के माध्यम से संसाधित करता है। कुछ मध्यवर्ती परिणाम जानबूझकर पुन: उपयोग किए जाते हैं: पाठ की स्थितियाँ नामों को चित्रों से मिलाने में मदद करती हैं और बाद में स्रोत को हाइलाइट करती हैं, जबकि चित्र से पढ़ी गई संरचना प्रत्येक प्रस्तावित नाम की पुष्टि के लिए उपयोग की जाने वाली पहचान प्रदान करती है।
- PDF तैयार करें। AtomLens एम्बेडेड टेक्स्ट को पढ़ता है और प्रत्येक पृष्ठ पर यह कहाँ दिखाई देता है, इसे रिकॉर्ड करता है। यदि किसी पृष्ठ में कोई उपयोग योग्य टेक्स्ट लेयर नहीं है, तो डिवाइस पर मौजूद AI मॉडल ऑप्टिकल कैरेक्टर रिकग्निशन (OCR) के साथ पृष्ठ को पढ़ता है।
- रासायनिक नाम खोजें। एक डिवाइस-स्थ AI मॉडल पाठ में संभावित रासायनिक नाम खोजता है। AtomLens सावधानीपूर्वक सामान्य PDF ग्लिफ और लाइन-रैप समस्याओं की मरम्मत करता है, फिर एक निर्धारणात्मक नाम-से-संरचना पार्सर जांचता है कि प्रत्येक उम्मीदवार किसी संरचना का वर्णन करता है या नहीं।
- संरचना आरेखों का पता लगाएँ। AtomLens सबसे पहले PDF में एम्बेडेड छवि और वेक्टर-ड्राइंग ऑब्जेक्ट्स की तलाश करता है। एक ऑन-डिवाइस AI सेगमेंटेशन मॉडल उपयुक्त ऑब्जेक्ट्स का निरीक्षण करता है और केवल तब पूरे पेज को स्कैन करता है जब PDF पेज इमेज हो या ऑब्जेक्ट एक्सट्रैक्शन अधूरा हो।
- प्रत्येक आरेख पढ़ें। एक डिवाइस-स्थ AI मॉडल प्रत्येक आरेख क्रॉप को SMILES में परिवर्तित करता है। AtomLens स्वतंत्र रूप से और निर्धारणात्मक रूप से उस SMILES को प्राधिकृत संरचना, CML, मानक और फिक्स्ड-एच पहचानों, तथा उपलब्ध रासायनिक गुणों में पार्स करता है।
- एक सत्यापित नाम संलग्न करें। AtomLens पहले ड्राइंग के पास पहले से ही पता लगाए गए नामों को आज़माता है। यदि कोई मेल नहीं खाता है, तो एक ऑफ़लाइन AI नामकरण मॉडल मान्यता प्राप्त SMILES से अधिकतम पाँच नाम प्रस्तावित करता है। एक नाम तभी संलग्न किया जाता है जब निर्धारणात्मक नाम पार्सिंग समान मानक और स्थिर-एच संरचना पहचानों को पुन: उत्पन्न करती है।
- परिणामों को संकलित करें। एक मेल खाने वाला निकटवर्ती नाम और चित्र एक पंक्ति में आ जाते हैं, और उसे चुनने पर दोनों स्रोत क्षेत्र हाइलाइट हो जाते हैं। शेष प्रविष्टियाँ अलग रहती हैं और समीक्षा, फ़िल्टरिंग, पूर्वावलोकन और आयात के लिए अपनी पृष्ठ स्थिति बनाए रखती हैं।
परिणामों को समझें
- Green — अनुवादित: निर्धारणात्मक नाम पार्सिंग ने निकाले गए नाम को स्वीकार किया। AtomLens एक संरचना थंबनेल दिखाता है।
- Green — निकटवर्ती नाम: AtomLens ने इस नाम को एक AI-पहचाने गए चित्र के पास पाया। निर्धारक पार्सिंग ने इसे स्वीकार किया, और दोनों संरचनात्मक पहचानों ने चित्र से मेल खाया। नाम और चित्र को एक परिणाम में संयोजित किया गया है।
- Green — उत्पन्न नाम: एक ऑन-डिवाइस AI मॉडल ने मुद्रित ड्राइंग को SMILES के रूप में पढ़ा और एक अलग ऑफ़लाइन AI मॉडल ने प्रदर्शित नाम का प्रस्ताव किया। फिर निर्धारणात्मक नाम पार्सिंग ने स्वतंत्र रूप से पार्स की गई ड्राइंग संरचना की दोनों Standard और Fixed-H पहचानों को पुन: उत्पन्न किया।
- Green — मान्यता प्राप्त ड्राइंग: ड्राइंग और इसकी प्रामाणिक CML को सफलतापूर्वक मान्यता दी गई, लेकिन कोई नाम सख्त पहचान गेट से नहीं गुज़रा। इसलिए AtomLens मान्यता प्राप्त SMILES को प्रदर्शन मान के रूप में रखता है।
- Orange — अनुवादित नहीं: एआई नाम पहचानक ने एक संभावित रासायनिक नाम पाया, लेकिन निर्धारणात्मक पार्सिंग इसे अनुवादित नहीं कर सकी। हाइलाइट किए गए स्रोत पाठ को प्रामाणिक संदर्भ के रूप में रखें।
- नारंगी रंग में ड्राइंग परिणाम का अर्थ है कि सेगमेंटेशन सफल रहा लेकिन क्रॉप पहचान या SMILES पार्सिंग सफल नहीं हुई। पहचाने गए ड्राइंग समीक्षा के लिए हाइलाइट किए गए रहते हैं।
- प्रत्येक पंक्ति एक घटना को दर्शाती है। इसलिए दोहराए गए नाम या चित्र एक से अधिक बार दिखाई देते हैं और अपनी पृष्ठ संख्याएँ बनाए रखते हैं।
खोजें और नेविगेट करें
- किसी पंक्ति का चयन करें ताकि वह PDF पृष्ठ पर प्रकट और हाइलाइट हो। टेक्स्ट अपने स्रोत दायरे का उपयोग करता है; एक ड्राइंग अपने पेज-स्पेस इंस्टेंस मास्क और बाउंडिंग बॉक्स का उपयोग करती है। कमांड-क्लिक व्यक्तिगत पंक्तियों को जोड़ता या हटाता है, और शिफ्ट-क्लिक चयन का विस्तार करता है।
- चुनें सभी चुनें, या दबाएँ
Command-Aजब परिणाम सूची सक्रिय हो, तो प्रत्येक दृश्यमान परिणाम का चयन करने के लिए। - PDF को फिर से स्कैन किए बिना निकाले गए शब्दों को फ़िल्टर करने के लिए टूलबार खोज क्षेत्र का उपयोग करें।
- केवल मान्य IUPAC नामों वाली पंक्तियाँ दिखाना डिफ़ॉल्ट रूप से सक्षम है। इसे बंद करें ताकि उन संभावित नामों की समीक्षा की जा सके जिन्हें अनुवादित नहीं किया जा सका और जिनके पास पहचान-मिलान नाम नहीं है, और उन रेखाचित्रों की भी समीक्षा की जा सके।
- उजागर किए गए PDF क्षेत्र पर क्लिक करें ताकि उसका परिणाम पंक्ति दिखाई दे। एक सक्रिय टेक्स्ट या सत्यापन फ़िल्टर उस पंक्ति को छिपा सकता है; इसे समीक्षा करने के लिए फ़िल्टर साफ़ करें।
- PDF पूर्वावलोकन के ऊपर ज़ूम आउट, फिट और ज़ूम इन नियंत्रणों का उपयोग करें।
- अनुवादित परिणाम पर डबल-क्लिक करें ताकि उसकी संरचना एक नई अणु विंडो में खुले।
- लोड किए गए थंबनेल या पहचानी गई संरचना ड्राइंग वाले अनुवादित नाम के लिए, दबाएँ
Spaceबड़े क्विक लुक संरचना पूर्वावलोकन को खोलने या बंद करने के लिए। ड्रॉइंग पूर्वावलोकन स्वतंत्र रूप से पार्स किए गए CML का उपयोग करते हैं। - चयनित पुष्टि किए गए नाम- और ड्राइंग-आधारित संरचनाओं को आयात करने के लिए 'प्रबंधित रिपॉजिटरी में आयात करें' चुनें। AtomLens दोहराए गए प्रसंगों को केवल Fixed-H InChIKey द्वारा एकीकृत करता है, उन चयनित प्रसंगों को छोड़ता और रिपोर्ट करता है जिनके लिए वह पहचान अनुपलब्ध है, प्रबंधित रिपॉजिटरी में पहले से मौजूद पहचान वाली संरचनाओं को छोड़ देता है, और प्रत्येक जोड़ी गई संरचना के लिए स्कैन किए गए PDF फ़ाइलनाम को स्रोत फ़ाइलनाम के रूप में दर्ज करता है।
मान्यता और सटीकता
AtomLens सबसे पहले एम्बेडेड PDF टेक्स्ट का उपयोग करता है। जब कोई पृष्ठ उपयोग योग्य टेक्स्ट प्रदान नहीं करता है, तो डिवाइस पर मौजूद AI मॉडल इसे OCR के माध्यम से पढ़ सकता है। फिर स्कैनर सामान्य PDF ग्लिफ और लाइन-रैप समस्याओं के एक सतर्क सेट को ठीक करता है, जिसमें लाइन अंतों पर विभाजित रासायनिक नाम शामिल हैं।
छपी हुई ड्रॉइंग्स के लिए, AtomLens पहले PDF की अपनी एम्बेडेड इमेज और वेक्टर ऑब्जेक्ट्स का निरीक्षण करता है। उपयुक्त ऑब्जेक्ट्स का सीधे उपयोग किया जाता है या डिवाइस पर मौजूद AI सेगमेंटेशन मॉडल द्वारा उनकी जांच की जाती है। एक पूर्ण-पृष्ठ एआई सेगमेंटेशन पास पेज-आकार के बिटमैप स्कैन, उपयोग योग्य ड्राइंग ऑब्जेक्ट्स के बिना पृष्ठों, या अपूर्ण ऑब्जेक्ट-स्तरीय तैयारी के लिए आरक्षित है। ड्राइंग क्रॉप्स को 300 DPI पर पैडिंग के साथ रेंडर किया जाता है, इससे पहले कि एक एआई ड्राइंग-पहचान मॉडल उन्हें पढ़े। एक अलग ऑफ़लाइन AI नामकरण मॉडल केवल ड्राइंग मान्यता के बाद, और केवल तभी व्यवस्थित-नाम के उम्मीदवारों का प्रस्ताव करता है जब कोई मेल खाने वाला पास का नाम नहीं मिला हो। AI आउटपुट स्वतंत्र रूप से पार्स किए गए CML को कभी भी प्रतिस्थापित नहीं करता है या संरचना की पहचान को परिभाषित नहीं करता है। यह पथ मुद्रित संरचना ड्राइंग के लिए है, हाथ से बनाई गई संरचनाओं के लिए नहीं। घने लेआउट, लेबल, प्रतिक्रिया योजनाएं, और खराब स्कैन अभी भी छूटे हुए या गलत ड्राइंग परिणाम बना सकते हैं।
स्कैन, असामान्य फ़ॉन्ट, आरेख, क्षतिग्रस्त वर्ण मानचित्र, बहु-स्तंभ लेआउट और आसन्न लेबल अभी भी अनुपस्थित, विभाजित या संयुक्त उम्मीदवार उत्पन्न कर सकते हैं। नारंगी परिणाम समीक्षा के लिए उपयोगी संकेत हैं, न कि इस बात का प्रमाण कि हाइलाइट किए गए शब्द एक मान्य IUPAC नाम बनाते हैं।
गोपनीयता और ऑफ़लाइन संचालन
- चयनित PDF, निकाला गया पाठ, AI-सहायक नाम पहचान, AI खंडन, AI रेखाचित्र पहचान, AI-सहायक व्यवस्थित नाम उत्पन्न, निर्धारणात्मक संरचना सत्यापन और थंबनेल इस डिवाइस पर संसाधित किए जाते हैं।
- सभी ML/AI मॉडल और टोकनाइज़र AtomLens के साथ शामिल हैं। ऐप रनटाइम पर कोई मॉडल डाउनलोड नहीं करता।
- AtomLens PDF या निकाले गए टेक्स्ट को किसी सेवा पर अपलोड नहीं करता है।
- फ़ाइल तक पहुंच केवल तभी शुरू होती है जब आप सिस्टम पिकर के साथ PDF का चयन करते हैं।